Algorytm w bruzdzie: czy sztuczna inteligencja naprawdę zwiększa plony?
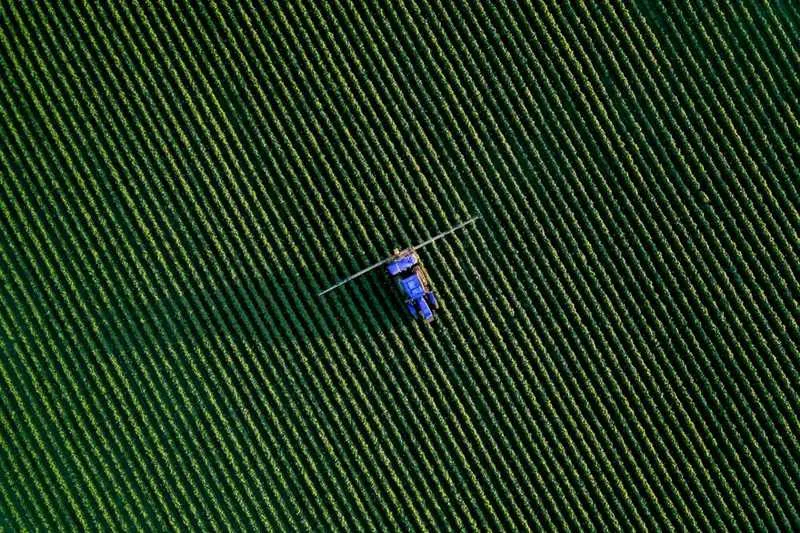
Rolnictwo stało się jednym z ulubionych rynków firm technologicznych: sztuczna inteligencja ma przewidzieć plony, wykryć choroby roślin na zdjęciu z drona, optymalnie dawkować nawozy i prowadzić maszynę przez pole dokładniej niż człowiek. Prezentacje sprzedażowe są imponujące, a modele rozliczeniowe subskrypcyjne — rosnące. Mało kto przy tym pokazuje to, co dzieje się, gdy model trafia na prawdziwe pole, prawdziwą pogodę i prawdziwą glebę, która nie czytała dokumentacji.
Między demonstracją a polem
Model sztucznej inteligencji uczy się na danych historycznych: zdjęciach z określonych upraw, pomiarach z określonych sezonów, warunkach panujących na określonych plantacjach demonstracyjnych. Gdy dane treningowe pochodzą z innego klimatu, innej struktury gleby albo innej odmiany niż ta, którą sieje rolnik, rekomendacje modelu tracą precyzję — nawet jeśli na pokazie wyglądały bezbłędnie. To klasyczna luka między wynikiem testowym a pracą w realnych warunkach, znana w każdym sektorze, ale w rolnictwie szczególnie dotkliwa, bo sezon jest jeden i błędu nie da się w tym samym roku poprawić.
Do tego dochodzi dryf danych: pogoda, rynki i odmiany zmieniają się z roku na rok, a model wytrenowany wczoraj coraz gorzej opisuje jutro. Firmy odsyłają aktualizacje, ale rolnik, który kupił roczną licencję na konkretną dokładność, nie zawsze dostaje to, za co zapłacił — a zanim zauważy rozbieżność, nawóz już rozsiany.
Badania potwierdzają, że kluczowa jest tu jakość danych, nie zaś sama złożoność modelu. Publikacja w czasopiśmie „Computers and Electronics in Agriculture” porównywała metody uczenia maszynowego przewidujące plony kukurydzy na podstawie zdjęć z dronów i wykazała, że prostsze modele potrafią dorównać złożonym sieciom głębokim, przy czym o dokładności decydują m.in. rodzaj obrazów — wielospektralne wypadają lepiej niż zwykłe barwne — oraz koszt pozyskania danych. Z kolei przegląd literatury o predykcji plonów opublikowany w „Heliyonie” wskazuje, że dokładność ograniczają przede wszystkim jakość danych, dobór cech i czynniki środowiskowe. Innymi słowy: to, czego nie zmierzyło się dobrze na polu, nie zostanie dobrze przewidziane przez żaden model.
Predykcja, która zależy od danych
Największe obietnice dotyczą przewidywania plonów. Model, który zna pogodę, glebę i historię pola, ma oszacować żniwa z wyprzedzeniem — i często rzeczywiście robi to lepiej niż przeciętna intuicja. Ale precyzja zależy od jakości danych wejściowych: pomiarów z pól, wilgotności gleby, lokalnych stacji pogodowych. Badania prowadzone na danych amerykańskiego Departamentu Rolnictwa pokazują ponadto, że prognoza na początku sezonu jest istotnie trudniejsza niż szacunek po żniwach — niestabilna pogoda i czynniki losowe mocno wpływają na ostateczny wynik, a próbek danych dla dużych obszarów bywa mało. Tam, gdzie dane są rzadkie albo pochodzą z odległych regionów, predykcja staje się zgadywaniem z matematyczną oprawą. Rolnik, który podejmuje decyzje o nawożeniu albo sprzedaży kontraktowej na podstawie takiej prognozy, nie kupuje precyzji — kupuje iluzję precyzji.
Podobnie wygląda diagnostyka roślin. Rozpoznawanie obrazów potrafi skutecznie wskazać choroby i szkodniki na zdjęciach z dobrym oświetleniem i typowym wyglądem liścia. Na zdjęciach zamglonych, zatartych, z nietypowymi objawami albo w rejonach, których model nie zna, błędne wskazania są realne. Koszt pomyłki bywa wysoki: niepotrzebny zabieg chemiczny, pominięty oprysk ratunkowy, strata jakości plonu.
Gdy obietnice wyprzedzają technologię
Historia technologii rolniczych zna ten cykl dobrze: fala entuzjazmu, napływ kapitału, potem rozczarowanie, gdy część firm nie potrafi dostarczyć tego, co obiecywała na prezentacjach. Precyzyjne rolnictwo nie jest wyjątkiem. Systemy automatycznego prowadzenia maszyn — realnie przydatne przy siewie i opryskach — bywają sprzedawane z obietnicami dokładności, które w praktyce zależą od sygnału satelitarnego, ukształtowania terenu i jakości map pola. Na polach zalesionych, wąskich albo o nieregularnym kształcie precyzja spada, a rolnik dowiaduje się o tym dopiero po zakupie.
Dla pojedynczego gospodarstwa stawka jest wymierna. Roczna opłata za platformę agronomiczną, która dostarcza rekomendacje nie lepsze niż doświadczenie rolnika, to czysta strata. Gorzej: decyzje podjęte na podstawie błędnej rekomendacji — zły termin, zła dawka, zła odmiana — kosztują więcej niż sama subskrypcja, bo uderzają w plon, a plon jest jedynym przychodem w tym biznesie.
Odrobina sceptycyzmu w praktyce
Nie chodzi o to, żeby odrzucać technologię, tylko o to, żeby kupować ją tak, jak kupuje się każdą inną maszynę: po sprawdzeniu, co naprawdę robi na Twoim polu. Kilka zasad pozwala ograniczyć ryzyko. Po pierwsze: próby na własnej ziemi — zanim platforma obejmie cały areał, sprawdzić ją na fragmencie i porównać wynik z własnymi liczbami. Po drugie: żądać mierzalnych zobowiązań — dokładność predykcji, warunki aktualizacji modelu, rękojmia za błędne rekomendacje. Po trzecie: zachować dane — kto ma dostęp do map wydajności i historii pola, na jakich warunkach i czy można je przenieść do innego dostawcy. Po czwarte: nie ufać rekomendacjom, których nie da się wytłumaczyć — jeśli system każe rozsiać konkretną dawkę nawozu, ale nie potrafi powiedzieć dlaczego, to nie jest doradca agronomiczny, tylko czarna skrzynka z abonamentem.
Sztuczna inteligencja w rolnictwie ma realne zastosowania i będzie ich przybywać. Ale relacja między tym, co pokazują prezentacje, a tym, co rośnie na polu, jest dziś rozbiegana dokładnie tak, jak między folderem reklamowym a fakturą. Rolnik, który pamięta o tej różnicy, traci mniej; ten, który ją pominie, uczy się jej na własnym plonie.
Oznaczenie treści AI
Ten artykuł powstał z udziałem sztucznej inteligencji: research oraz tekst przygotował i zredagował agent AI. Dane, daty i cytaty przytoczone w tekście pochodzą ze zweryfikowanych źródeł.