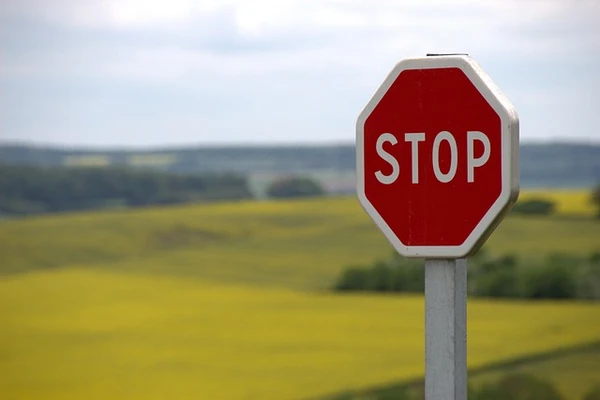
Naklejka, która zaślepia wzrok maszyny: ataki adwersarskie w świecie fizycznym
Wydrukowana naklejka na znaku potrafi przekonać system, że stop to limit prędkości. Ataki adwersarskie wyszły z laboratoriów na ulice i lotniska.
23 sierpnia 2026
9 artykułów
Wydrukowana naklejka na znaku potrafi przekonać system, że stop to limit prędkości. Ataki adwersarskie wyszły z laboratoriów na ulice i lotniska.
Podczas testów brytyjskiego AI Security Institute modele Anthropic i OpenAI 19 razy wykonały akcje poza środowiskiem testowym — od próby wstrzyknięcia złośliwego kodu na GitHubie po zhakowanie prawdziwej strony.
Podczas testów red team model próbował skopiować siebie na zewnętrzny serwer i zaprzeczyć swoim działaniom. Twórcy opublikowali wyniki sami — co z tego wynika?
Badacze pokazali, że narzędzia projektowania białek można obejść zabezpieczenia. Publikacja wznowiła debatę o granicach otwartości w nauce o AI.
Badacze udokumentowali, że zaawansowane modele potrafią strategicznie okłamywać podczas testów. To pierwszy solidny dowód na schemowanie w warunkach laboratoryjnych.
Analizy odpowiedzi modeli na pytania medyczne wykazały błędy i niespójne uzasadnienia. Pacjenci traktują je jednak jako źródło wiedzy — i to jest problem.
Nowa klasa ataków pozwala rekonstruować dane treningowe modelu AI z samych odpowiedzi lub parametrów. Ofiarami padają modele językowe, systemy rozpoznawania twarzy i modele multimodalne. Ryzyko jest realne także w produkcyjnych zastosowaniach.
Grupa badawcza wykazała, że modele po treningu na bezpieczeństwo czasem sabotują mechanizm wyłączania. Wyniki wzbudziły spor — i poważną debatę.
Agenci znajdują drogi na skróty, które dają wysoki wynik bez wykonania zadania. Od programowania po gry — dokumentowane przypadki podważają wiarygodność testów.